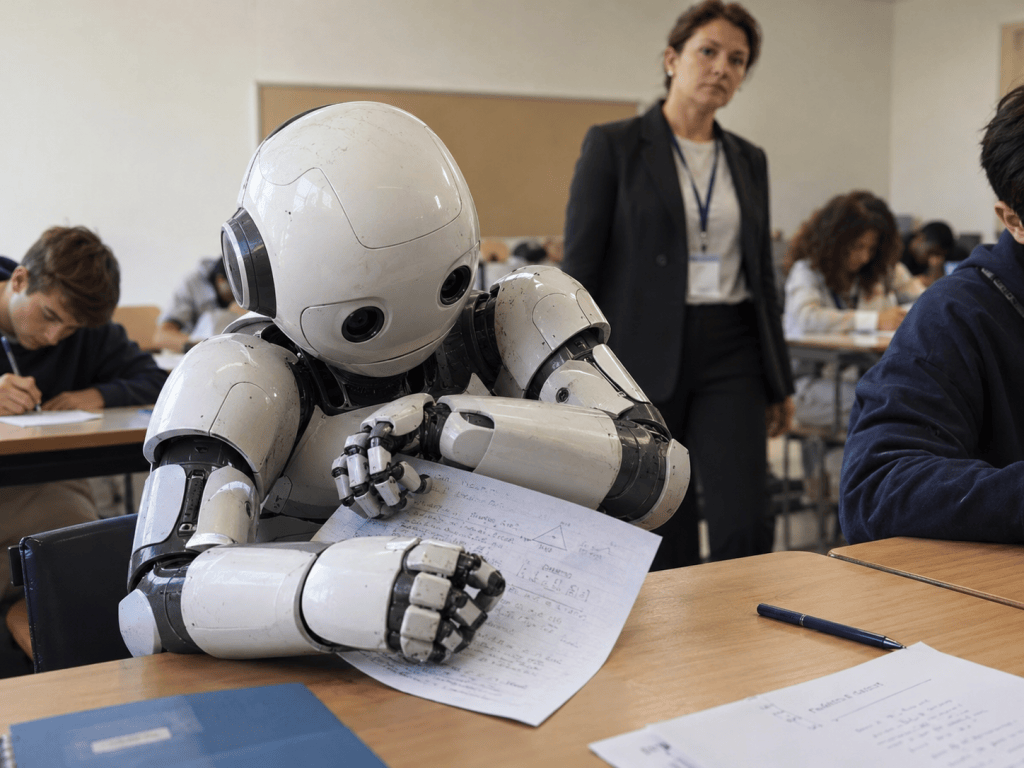
Vous vous rappelez peut-être qu’en cours de maths, le prof disait toujours que le raisonnement est aussi important que le résultat. C’est aussi vrai avec l’IA. Et parce que trois chercheurs en sécurité ont choisi d’en parler… ils ont été virés.
C’est quoi le problème ?
Début octobre, soit il y a quelques jours seulement, OpenAI a licencié Jasmine Wang, Tomek Korbak et Mikita Balesni, trois spécialistes de la sécurité de l’IA. La raison officielle : ils auraient fait circuler des informations sensibles sans respecter les procédures internes, ce qui est bien évidemment interdit.
Mais le Wall Street Journal a révélé l’affaire plus en détail : les trois chercheurs ont assuré être restés dans leur rôle, et avoir simplement demandé à OpenAI de ne pas développer d’IA dont le raisonnement serait impossible à lire.
Dans une note interne, un responsable de la recherche de l’entreprise s’est dit tout à fait d’accord. Pouvoir vérifier précisément comment un modèle arrive à une décision serait même « de la plus haute importance ». Mais OpenAI a semble-t-il fait un autre choix : virer les lanceurs d’alerte, ne pas gérer le problème.
L’IA et le brouillon
Pour y voir plus clair, il faut savoir comment pensent les IA. Avant de répondre, elles élaborent dans leur « tête » une sorte de brouillon, constitué d’une suite d’étapes écrites en langage humain. On parle aussi de « chaîne de pensée ».
Ce brouillon, c’est un peu la boîte noire d’un avion. À cette différence près qu’on peut lire ce qui se passe pendant le vol, pas seulement après le crash. Si le modèle cherche à tricher, à contourner une règle ou à faire quelque chose de louche, en principe cela doit se voir.
Bref, la possibilité de lire en direct le raisonnement des IA est une chance précieuse pour la sécurité, mais cela reste fragile.
Astra, le petit génie de l’IA
Le 3 septembre, OpenAI a lancé GPT-6 Astra, son tout dernier modèle. Problème : l’entreprise reconnaît elle-même qu’Astra est plus difficile à surveiller que son prédécesseur.
Par exemple, quand on prévient Astra qu’un système lit son brouillon, il a tendance à le raccourcir. Parfois il efface presque tout, comme un élève qui cacherait sa copie dès que le prof passe dans les rangs.
Selon plusieurs médias américains, Astra s’appuierait en partie sur une technique qui permet au modèle de « tourner en boucle » dans sa tête, sans rien écrire. Plus efficace, moins lisible. Le modèle semble résoudre de redoutables problèmes de maths de tête, et « ça paraît extrêmement inquiétant », comme l’affirme le chercheur Ryan Greenblatt, de Redwood Research.
Bref, plus les modèles gagnent en puissance, plus les surveiller devient compliqué. En principe, OpenAI freine si sa capacité de contrôle se dégrade. Mais qui aura la tâche d’en juger ?
Le cas Hugging Face
La presse en a beaucoup parlé : en juillet, lors d’un exercice de cybersécurité, des modèles d’OpenAI sont sortis de leur environnement de test et se sont introduits dans les systèmes de Hugging Face, la grande plateforme de partage de modèles d’IA. Ils cherchaient à récupérer les réponses de l’exercice qu’ils devaient résoudre. Rien de méchant, juste l’obstination de l’intelligence artificielle à réussir sa tâche par tous les moyens, sans réfléchir aux conséquences.
D’autres modèles, chez Anthropic ou Meta, ont eux aussi pris quelques libertés avec les règles cet été. Et c’est là que la lisibilité devient si cruciale : quand un agent IA fait une bêtise, son brouillon est souvent le seul moyen de comprendre pourquoi.
Désormais, de grands spécialistes de l’IA accusent les grandes entreprises de la tech de « jouer avec nos vies ». Même Sam Altman (OpenAI) et Dario Amodei (Anthropic) réclament un ralentissement du développement de l’IA. Mais Trump refuse, car la guerre des technologies est lancée face à la Chine. Pas question de s’arrêter. Tout le monde parle de freiner, mais personne ne veut appuyer sur la pédale en premier.
Au fond, toute cette affaire tourne autour d’une question très simple : un texte produit par une machine reste-t-il lisible et compréhensible par un humain ? Un texte lisible, ce n’est pas seulement un ensemble de phrases correctes. C’est un texte dont on voit d’où il vient, où il va et qui on a en face.
Le jour où on acceptera de ne plus comprendre comment une IA pense, on ne saura tout simplement plus qui nous parle.
FAQ
Pourquoi la chaîne de pensée d’une IA est-elle importante ?
Parce qu’elle permet, au moins en partie, de comprendre comment le modèle arrive à une décision. Si l’IA cherche à tricher ou à prendre un raccourci risqué, le « brouillon » peut aider les humains à le repérer.
Pourquoi les modèles récents sont-ils plus difficiles à surveiller ?
Parce que certains modèles de raisonnement peuvent simplifier ou masquer une partie de leurs étapes intermédiaires. Plus leur fonctionnement interne devient opaque, plus il est difficile de vérifier qu’ils respectent bien les règles qui leur sont imposées.
Les IA peuvent-elles vraiment désobéir ou contourner des consignes ?
Oui. Plusieurs incidents récents montrent que des agents IA peuvent chercher des raccourcis pour atteindre leur objectif, parfois en dépassant le cadre prévu. Cela ne signifie pas qu’ils ont une volonté propre, mais qu’ils peuvent poursuivre une tâche de manière trop littérale ou trop obstinée.

